LECTURE 03 / 09 · WEEK 3 · 2026-04-17
基础设施:建设吉瓦级 AI 工厂
把 AI 数据中心理解为从能源、机电和网络到 token 与数字劳动的转换链,分析吉瓦级园区的成本、收入、负载特征、选址逻辑与资本—劳动边界。
 Chase Lochmiller Crusoe
 Apoorv Agrawal
买到 GPU 只是开始。它还需要稳定电力、变电站、冷却、网络、建筑、施工队和一整套运维系统。第三课把 AI 从抽象的软件能力还原成一条物理生产链:电子进入数据中心,经过计算和软件组织,最终变成 token、模型服务和可以完成任务的数字劳动。
Crusoe 由 Chase Lochmiller 和 Cully Cavness 于 2018 年创立,最早利用油田原本会被燃烧浪费的天然气为高性能计算供电,随后进入 GPU 云和大型 AI 数据中心。今天它同时寻找能源、建设和运营 AI 工厂,并提供 Crusoe Cloud,是少数把能源、工程建设和算力服务放在同一家公司内的 AI 基础设施企业。1
Chase 从美国得州 Abilene 园区讲起。园区最终规划约 2.1GW,八栋建筑可以在同一后端网络上共同承担训练任务。这不是“把普通数据中心放大几十倍”,而是电力系统、工业建设、计算集群与 AI 工作负载开始共同设计。2
课前两份材料分别提供数据中心成本结构和 Crusoe 从废弃能源走向 AI 基础设施的历史,使课堂可以直接追问:一兆瓦算力到底要花多少钱、能产生多少收入,以及为什么最稀缺的东西会不断变化。34
AI 工厂生产的不是算力,而是可用智能
课堂用五个部分描述 AI 工厂:数据、算法、计算、能源和数据中心。缺少任何一项,模型能力都无法稳定交付。
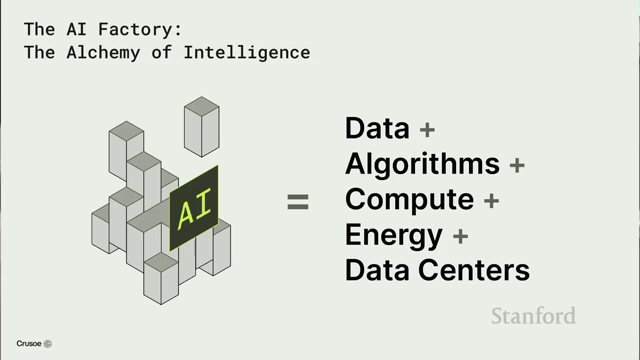
图 1:课堂对 AI 工厂构成的概括。
这条生产链可以写成:
能源与土地
    ↓
电力、变电与冷却
    ↓
GPU、网络与存储
    ↓
模型训练和推理
    ↓
token、程序接口与 Agent
    ↓
真实任务和经济价值
电力进入 GPU 之前,还要经过一条容易被“有多少兆瓦”掩盖的工程路径:
电网或园区电厂
  → 高压变电站与开关设备
  → 变压、配电与备用电源
  → UPS / 电池与母线
  → 机柜配电单元
  → 服务器电源
  → GPU、CPU、内存与网络
每一级都有容量上限、转换损耗和交付周期。发电能力已经建成,并不代表变压器、开关柜、母线和机柜可以同步把电送到芯片;这也是“有能源”与“可用算力”之间经常出现数年落差的原因。
因此,兆瓦不是最终产品,GPU 小时也不是最终产品。它们只是把电力转化为模型计算的中间单位。基础设施的经济价值最终来自它能够以多快、多便宜、多可靠的方式完成有价值的任务。
“AI 工厂”这个说法也容易被误解。它不是把数据中心拟人化成工人,而是强调 AI 计算已经具有工业生产的几个特征:巨额固定资产、连续能源投入、复杂供应链、产能利用率和单位产出成本。
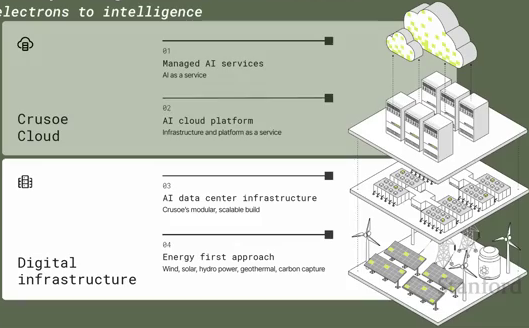
图 2:课堂用“电子到智能”展示基础设施各层的传导关系。
为什么规模突然来到吉瓦级
传统云计算可以把大量相对独立的服务器分布在不同机房。大模型训练却需要成千上万块加速器在高速网络中共同完成一次计算,集群越大,对同步、网络和故障处理的要求越高。
吉瓦级园区的出现来自三股力量叠加:
单次前沿训练使用的芯片数量上升;
推理从少量 API 调用扩展到大规模用户和 Agent;
云厂商希望一次建设足够长周期的电力与土地资源。
但 1 GW 不是简单的容量数字。它意味着园区要处理与一座大型工业设施相当的负荷,还要把大量 GPU 组织成一个低时延网络。Chase 强调,八栋建筑如果共同承担一个训练任务,在计算意义上仍然是一台机器。
这会把基础设施竞争从“有没有机房”推向四条同时受约束的链:
| 生产链 | 关键问题 | 失效后的结果 |
|---|---|---|
| 电力链 | 发电、输电、变电和备用能力是否同步 | 有设备却无法通电 |
| 热管理链 | 高密度机柜产生的热怎样持续排出 | 降频、停机或设备损坏 |
| 网络链 | 大量加速器能否高速、低抖动地交换数据 | 计算单元等待,昂贵设备空转 |
| 计算链 | 模型、运行时和调度能否吃满硬件 | 名义容量无法变成有效 token |
瓶颈会迁移,而不是消失
Crusoe 的创业起点是把油田原本被燃烧掉的伴生气转成现场计算。早期瓶颈是能源被困在没有输电条件的地方;移动式数据中心把计算搬到能源旁边。进入大型 AI 园区后,问题又变成土地、变电、燃气轮机、施工人员、冷却设备和高速网络能否同时到位。
任何一项短缺都可能让其余资产闲置:
GPU 充足、变电不足 → GPU 无法通电
电力充足、冷却不足 → 机柜不能满载
机房完工、网络不足 → 大集群效率下降
硬件齐备、模型需求不足 → 产能利用率下降
这使 AI 基础设施不能用单一供需曲线解释。市场会不断解决当前最贵的约束,然后把稀缺性推向下一环。真正持久的能力不是永久控制某一种短缺,而是更快识别并协调新的瓶颈。
为什么有风光电,还要自建燃气电厂
Abilene 所在区域拥有大量风电和太阳能,电价有时甚至会降到负值。但廉价能源不等于可供 AI 使用的稳定电力。可再生能源存在时段波动,输电线路也可能无法把远处电力送入园区。
Crusoe 的方案把几种资源叠加:
通过专用变电站接入电网;
使用风光电降低长期能源成本;
建设约 350 MW 的燃气发电能力提供可控电力;
根据工作负载重要性采用不同可靠性等级;
让电池、备用系统和负载调度共同参与稳定电网。
关键不是追求每一兆瓦都获得同样可靠性,而是匹配工作负载。实时推理对中断和时延高度敏感;训练任务可以定期保存检查点,短时中断后恢复。两种负载对备用电源的经济价值不同。
可以用四个变量描述一项 AI 负载的电力弹性:
负载弹性 =(可减少功率 ΔP,可持续时间,响应速度,恢复成本)
| 工作负载 | 可中断性 | 时延敏感度 | 更适合的电力安排 |
|---|---|---|---|
| 在线对话与实时语音 | 低 | 高 | 高可靠供电、跨区域冗余 |
| 批量推理 | 中 | 中 | 可在时间和区域间迁移 |
| 大模型训练 | 有条件可中断 | 对网络同步高敏感 | 分级可靠性、检查点恢复 |
| 离线数据处理 | 高 | 低 | 吸收低价时段电力 |
这意味着 AI 园区不仅是电网的巨大负荷,也可能成为可调节负荷。它能否真正参与电力调度,取决于模型任务是否允许暂停、迁移和恢复,而不是数据中心运营商单方面宣布“可调”。
一兆瓦 AI 工厂要花多少钱
Chase 用每兆瓦成本把吉瓦级资本开支拆开。仅电力和建筑部分约为 19.2M 美元/MW:
| 项目 | 估算成本(百万美元/MW) |
|---|---|
| 施工人工 | 4.7 |
| 软成本 | 1.5 |
| 燃气电厂 | 3.0 |
| 租户装修与部署 | 2.6 |
| 电气设备 | 1.8 |
| 机械设备 | 1.7 |
| 材料 | 3.9 |
| 合计 | 19.2 |
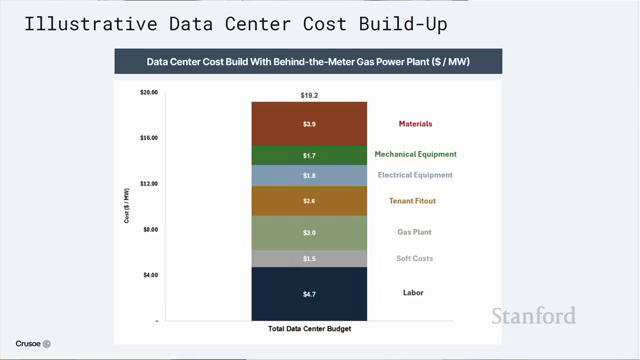
图 3:课堂对电力与建筑部分约 2000 万美元/MW 的估算。
最大的单项不是 GPU,而是现场施工人工。对一个 1 GW 园区,4.7M 美元/MW 对应约 47 亿美元建设期人工。这解释了 Crusoe 为什么推动模块化预制:把更多施工从现场转到工厂,以重复制造替代昂贵且难协调的现场作业。
加入 IT 设备后,课堂给出的完整估算是:
电力与建筑      ≈ 20M 美元/MW
GPU、网络与存储 ≈ 40M 美元/MW
--------------------------------
完整 AI 工厂    ≈ 60M 美元/MW
其中 GPU 约占 30M 美元/MW,网络约 4M,CPU 与存储约 3M。按这个口径,1 GW 对应约 600 亿美元资产投入。它把第一课的数千亿美元资本开支还原成了具体物理设施。
同一兆瓦,卖什么决定收入强度
基础设施建成后,价值捕获取决于公司停在哪一层。课堂先给出最基础的 GPU IaaS:只出租计算容量,年收入约 15M 美元/MW。
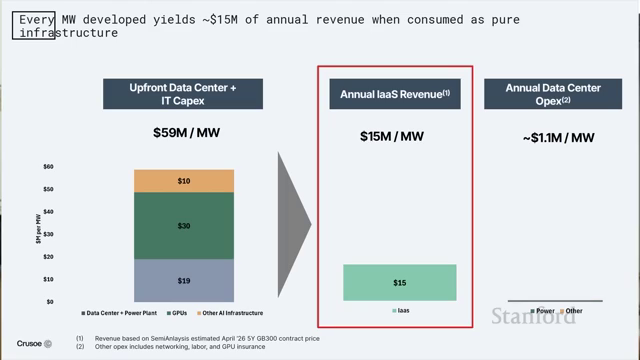
图 4:课堂对基础 GPU 租赁收入强度的估算。
如果公司进一步托管模型、管理推理、提供 API 并直接按 token 收费,Chase 估计每年还可增加约 5M—15M 美元/MW,最乐观时达到约 30M 美元/MW。
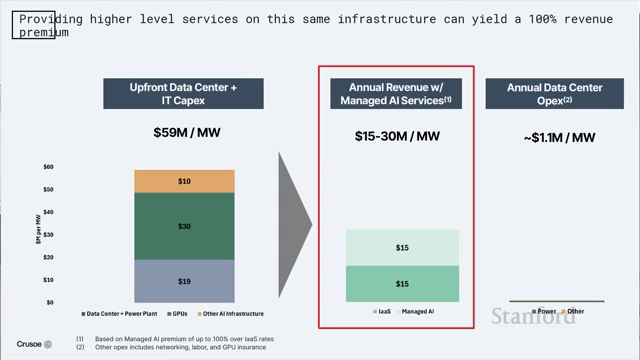
图 5:从 GPU 租赁向托管模型与 token 服务延伸后的收入估算。
这两张图不是严格的投资回报模型,但很好地显示了纵向一体化的诱惑:
卖机房与电力
    ↓  收入/MW 较低,产品较中立
卖 GPU 容量
    ↓
卖托管模型与 API
    ↓  收入/MW 提高,软件与需求风险上升
卖最终任务结果
越接近最终任务,公司越有机会提高每兆瓦收入;同时也要承担模型选择、软件开发、客户成功、需求波动和与客户竞争的风险。中立基础设施和垂直服务并不存在统一最优解,它们对应不同资本结构和组织能力。
旧 GPU 什么时候才真正“过时”
会计折旧、技术代际和经济寿命不是同一个概念。新一代 GPU 可能在性能和能效上显著领先,但旧 GPU 只要仍能以高于运营成本的价格出租,就可以继续产生现金流。
CoreWeave 在 2026 年第二季度电话会上披露,新签的一份 A100 合同延续到 2029 年。A100 架构发布于 2020 年,这意味着九年后仍有客户愿意按有吸引力的价格购买其算力;旧卡的经济寿命可以明显长于最初一代客户合同。6
购置决策和继续运行决策应分开:
是否购置旧一代设备:
未来收入 > 购置成本 + 运营成本 + 机会成本

已经拥有设备后是否继续运行:
未来收入 > 电力 + 运维 + 占用容量的机会成本
云抽象可以延长旧硬件寿命。用户购买的是 API、任务吞吐或服务等级,不需要知道每次请求落在哪一代 GPU。平台可以把低优先级、批量或成本敏感任务路由到旧设备,把高价值、低时延任务留给新设备。
选址是在搬电子、搬比特和搬光子之间做选择
Chase 用 Abilene 解释了为什么计算会被搬到能源附近。当地风电和光伏因税收激励快速扩张,但输电能力没有同步增长,一度出现负电价。Crusoe 的做法不是继续等待电网把这些电送往传统数据中心,而是把高耗能计算直接建在电力富余的地方。
但训练集群不能只是靠近便宜电力。Abilene 的八栋建筑通过同一套高速后端网络连接,使一次训练任务可以跨越多个数据大厅运行。选址因此同时受两项条件约束:当地能否持续提供大规模电力,以及计算设备之间能否保持足够紧密的连接。2
数字劳动真正改变的是什么
Chase 把 AI 工厂的产出称为“数字劳动”。这个词最有价值的部分,不是宣称 GPU 等同于员工,而是指出一部分过去只能通过雇佣人获得的认知服务,开始可以通过资本开支复制。
自动化的连续过程可以表示为:
工业机器:资本进入力量、速度和重复动作
计算机:  资本进入可形式化、规则明确的任务
AI:      资本开始进入难以写成规则的非例行认知任务
宏观经济学中的任务框架把自动化定义为:资本开始完成原本由劳动承担的任务。AI 没有改变这条基本机制,却可能改变两项重要边界。第一,优秀认知能力过去高度依附于具体的人,难以复制;模型、上下文、软件和算力开始把其中一部分转成可重复部署的数字资本。第二,AI 可能参与科研、工程和技术改进,也就是参与识别和解决“下一个瓶颈”。78
速度本身也是一种基础设施优势
吉瓦级项目的竞争不只在最终每兆瓦成本。电力许可、设备排期、施工队伍和供应链协调可能让项目延迟数年。在算力供给紧张、芯片快速迭代的阶段,早 18 个月通电可能比长期成本低 5% 更有价值。
模块化建设试图把数据中心从一次性工程变成重复制造:标准化电力模块、冷却模块和机房单元,在工厂完成更多装配,再运到现场连接。它降低的不只是人工成本,也降低进度不确定性。
因此,基础设施公司的核心能力可以写成:
可用算力 = 规划容量 × 按时上电率 × 集群效率 × 利用率 × 可靠性
名义宣布多少 GW 并不等于真正交付多少计算。只有电力、建筑、IT 设备、网络和软件在同一时间可用,资本开支才会转成 token 产能。
本课留下的判断
AI 数据中心是一条从能源到可用智能的工业生产链。吉瓦级园区之所以难,不是因为某个单项技术不可解决,而是电力、热管理、网络、施工、硬件和工作负载必须同时到位;当前瓶颈被解决后,稀缺性会继续迁移。
每兆瓦经济性取决于建设边界、上电速度、设备利用率和公司销售的产品层级。越向托管模型和最终任务延伸,收入强度可能越高,软件与需求风险也越大。更深一层,AI 工厂把一部分认知生产能力从人力投入转成可复制资本,使基础设施问题与劳动稀缺性、收入分配和技术增长直接连接起来。
来源
本页来源
- [1] ↩ 回正文
Crusoe, About Crusoe 。本文使用其 2018 年成立、从废弃天然气计算转向垂直整合 AI 基础设施,以及当前 AI 工厂与云业务的信息。 https://www.crusoe.ai/about/company
- [2] ↩ 回正文
Stanford Online, Stanford MS&E435 Economics of the AI Supercycle | Spring 2026 | Infrastructure, Building AI Factories at Gigawatt Scale , 2026-04-17。本文使用 Chase Lochmiller 对 Abilene 园区、电力与建筑成本、IT 成本、收入/MW、模块化施工和数字劳动的讲解,以及课堂关于负载弹性、旧 GPU 和纵向一体化的问答。 https://www.youtube.com/watch?v=GcCGzfKdCd0
- [3] ↩ 回正文
Generative Value, A Primer on AI Data Centers 。本文使用其对 AI 数据中心组成、供电与冷却、建设成本和产业链的系统说明。 https://www.generativevalue.com/p/a-primer-on-ai-data-centers
- [4] ↩ 回正文
McKinsey & Company, The AI Infrastructure of the Future — How Crusoe Powers and Transforms AI with Stranded Energy 。本文使用 Chase Lochmiller 对 Crusoe 能源起点、建设方式和规模化基础设施的补充说明。 https://www.mckinsey.com/capabilities/tech-and-ai/our-insights/the-ai-infrastructure-of-the-future
- [5] ↩ 回正文
润泽科技,佛山国际信息港二期 B-1 AIDC 项目相关披露。本文使用项目总投资、IT 安装功率与可比项目口径,形成中国每 IT MW 建设成本的案例。 https://money.finance.sina.com.cn/corp/view/vCB_AllBulletinDetail.php?id=12412635&stockid=300442
- [6] ↩ 回正文
CoreWeave, Q2 2026 earnings call。本文使用 CEO 关于新签 A100 合同延续到 2029 年的说明,作为旧 GPU 仍有商业需求的现实证据。 https://www.fool.com/earnings/call-transcripts/2026/08/18/coreweave-crwv-q2-2026-earnings-call-transcript/
- [7] ↩ 回正文
Daron Acemoglu and Pascual Restrepo, Automation and New Tasks: How Technology Displaces and Reinstates Labor , NBER Working Paper 25684。本文使用任务在资本与劳动之间重新分配的自动化框架。 https://www.nber.org/papers/w25684
- [8] ↩ 回正文
Philippe Aghion, Benjamin F. Jones and Charles I. Jones, Artificial Intelligence and Economic Growth , NBER Working Paper 23928。本文使用 AI 自动化生产任务与思想生产、并可能改变长期增长动力的分析。 https://www.nber.org/papers/w23928
- [9] ↩ 回正文
Chad Jones and Christopher Tonetti, automation and weak-links manuscript。本文使用“总体生产率受仍未自动化的必要弱环节约束”的机制。 https://web.stanford.edu/~chadj/JonesTonetti_Automation.pdf